

La inteligencia artificial tiene una cara innovadora, pero también una factura que pagar. Y en los últimos meses, esa factura ha empezado a preocupar a los CIO de todo el mundo, que ya lidian con un reto de siempre: demostrar el ROI de sus inversiones en IA.
Puntos clave
- El coste unitario de los tokens baja, pero la complejidad y el consumo de los flujos agénticos crecen más rápido. Muchas empresas superan con creces los presupuestos previstos.
- Razonamiento, llamadas repetidas, contextos extensos, herramientas externas y autonomía: todo suma. No hay una única causa, sino una cadena de multiplicadores de coste a menudo difíciles de prever.
- Los agentes deben diseñarse no solo para cumplir sus objetivos, sino también para operar de forma eficiente. Es posible, siempre que se cuente con las competencias y la experiencia necesarias.
La paradoja de la inferencia: empresas que gastan más de 1 millón de dólares al año
En agosto de 2026, Gartner acuñó el término la paradoja de la inferencia y la describió así: «En 2028, los costes de inferencia por flujo de trabajo agéntico se multiplicarán por más de cinco». La paradoja reside en que el coste unitario de las llamadas, medido en tokens, sigue bajando, mientras que el gasto global de las empresas no deja de crecer.
Pero ¿cuánto están gastando las empresas? Según IDC, las empresas con visibilidad sobre sus costes declaran un gasto medio mensual de 117.558 dólares en servicios de inferencia y orquestación, es decir, más de 1,4 millones de dólares al año. Y esto es solo el principio.
Sin embargo, quizá el dato más relevante tiene que ver con la incapacidad de prever el gasto: según IDC, en los últimos doce meses, el 67 % de las empresas ha superado en más de un 10 % su presupuesto para agentes de IA; un 24 % lo ha rebasado por un margen aún mayor.
Y cuando el presupuesto se dispara, las empresas reaccionan de la forma más directa posible: aplazan otros proyectos de IT y el 43,1 % reduce plantilla para compensar el gasto adicional.
Está claro que ha llegado el momento de buscar una tercera vía, partiendo de una premisa: la IA no es cara porque cada token cueste demasiado, sino porque una tarea aparentemente sencilla pone en marcha toda una cadena de consumo.
Un flujo de trabajo agéntico puede consumir 1.000 veces más tokens que un chat
Para un CIO, la diferencia entre un chat y un flujo de trabajo es cada vez más evidente. En un chat estándar, el modelo recibe una pregunta, recurre a su conocimiento y genera una respuesta. Un flujo agéntico debe razonar, planificar, usar herramientas, analizar resultados, revisar su propio trabajo y, si hace falta, volver sobre sus pasos.
Quien haya experimentado con las capacidades de razonamiento de los modelos de IA habrá notado que, a medida que aumenta la complejidad, también aumentan los tiempos de procesamiento y el consumo de tokens, lo que dispara los costes. Pero para entender a dónde va realmente ese dinero, hay que profundizar un poco más.
El modelo consume recursos varias veces
El primer multiplicador es interno a una sola llamada. Ante un problema complejo, el modelo no genera una respuesta de inmediato: utiliza sus capacidades de razonamiento para analizar la información, evaluar alternativas y construir el resultado. Este procesamiento requiere tokens adicionales, aunque, desde el punto de vista del usuario, todo parezca ocurrir en respuesta a un único prompt. La forma más sencilla de notarlo son los tiempos de procesamiento, que no tienen nada que ver con los de un chat estándar.
El segundo multiplicador, en cambio, depende de la estructura del flujo de trabajo. Pensemos en el procesamiento de una factura entrante. El modelo extrae del documento el proveedor, el importe y el número de pedido. A partir de estos datos, el flujo consulta el ERP, recupera los datos maestros del proveedor y comprueba que la mercancía y los importes coinciden con el pedido. Si surge una discrepancia, el sistema envía al modelo información que antes no tenía y le pide que interprete la discrepancia, decida qué comprobaciones adicionales realizar o prepare una solicitud de aclaración. La respuesta resultante puede desencadenar nuevas comprobaciones y, por tanto, llamadas adicionales. Es este ir y venir entre razonamiento, acceso a los sistemas corporativos y resultados sucesivos lo que convierte una sola petición del usuario en una secuencia de operaciones de inferencia.
Como señala McKinsey: «lo más caro no es generar la primera respuesta, sino el proceso posterior de comprobar, corregir y volver a comprobar». Dicho de otro modo, generar una respuesta es relativamente barato; hacer que sea fiable, mucho menos.
La autonomía no siempre es algo positivo
Los CIO necesitan costes predecibles. Los modelos de IA y los flujos agénticos, si no se gobiernan bien, van en la dirección contraria. Un agente no sigue necesariamente el mismo camino que otro agente que realiza una tarea similar: puede elaborar planes distintos, elegir otras herramientas, repetir una búsqueda, revisar una decisión o quedar atrapado en un bucle de reintentos.
El resultado es que dos ejecuciones de la misma tarea pueden tener costes radicalmente distintos. Un estudio de 2026 realizado sobre ocho modelos frontera detectó variaciones de hasta 30 veces en el consumo de tokens para una misma tarea. Esos mismos modelos tampoco fueron capaces de predecir bien su propio consumo de antemano y tendían a subestimarlo.
Hay además una segunda cuestión: usar más tokens no garantiza más precisión. El rendimiento suele alcanzar su punto óptimo en un nivel de consumo intermedio y después se estanca aunque se siga gastando. Por tanto, en el mundo agéntico, añadir pasos, comprobaciones y razonamiento no conduce necesariamente a mejores resultados. La complejidad puede convertirse en consumo sin valor.
La inferencia no es el único coste
Un flujo agéntico no depende solo del modelo de IA. Puede realizar búsquedas, consultar bases de datos, ejecutar código, generar imágenes o acceder a plataformas SaaS. Cada llamada conlleva, por tanto, costes adicionales: APIs, capacidad de cómputo, licencias, almacenamiento y transferencia de datos. El coste de un flujo es la suma de todos estos cargos, no solo de los tokens.
La velocidad y la disponibilidad tienen un coste, incluso cuando no se utilizan
Los agentes de IA están entrando en procesos de negocio críticos, donde no basta con ofrecer un resultado de calidad: tiene que llegar rápido y el servicio debe estar disponible en todo momento. Garantizar tiempos de respuesta constantes, incluso en los picos de demanda, exige capacidad de cómputo reservada, infraestructura redundante y margen suficiente para absorber aumentos repentinos de la demanda. La empresa sigue pagando por estos recursos incluso cuando el tráfico baja, y quedan parcialmente sin utilizar.
La arquitectura determina el coste de los agentes de IA
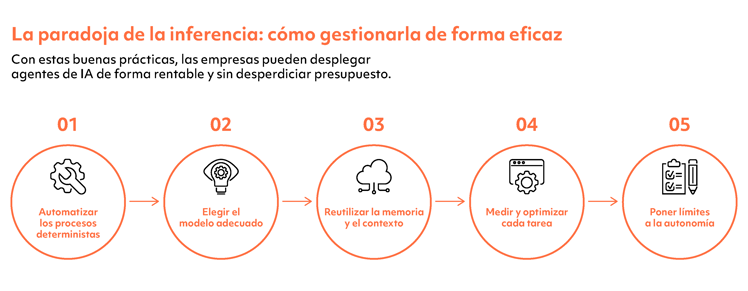
No existe una única técnica validada para resolver la paradoja de la inferencia. La regla fundamental es diseñar los agentes para que usen la IA solo cuando sea necesario, en la medida justa y dentro de límites bien definidos. La eficiencia no se puede añadir al final: tiene que estar integrada en la arquitectura del flujo desde el principio. De lo contrario, una sorpresa desagradable es casi inevitable.
No uses IA cuando basta con una base de datos
Los cálculos, filtros, comparaciones y reglas deterministas no requieren un modelo de lenguaje. Si una operación puede resolverse con una consulta SQL o unas pocas líneas de código, delegarla en la IA la hace más cara, más lenta, menos predecible y menos fiable. El modelo debe intervenir cuando se necesita interpretación, razonamiento o gestión de la ambigüedad.
Asigna el modelo adecuado a cada tarea
Pocas tareas requieren el modelo más potente y caro. La extracción, la clasificación y el resumen pueden resolverse con modelos ligeros, mientras que el razonamiento complejo y las decisiones de alto riesgo pueden justificar el uso de modelos más avanzados. Es imprescindible contar con directrices claras, junto con un sistema de enrutamiento que seleccione el modelo según la complejidad, el valor y el riesgo de cada tarea.
No pagues dos veces por el mismo trabajo
Un agente eficiente debe avanzar de forma incremental, conservando los resultados intermedios en lugar de reconstruirlos en cada paso. Puede parecer obvio, pero sin reglas claras, el modelo repite el ciclo completo. La información estable puede almacenarse o guardarse en caché; la información temporal puede resumirse o descartarse cuando ya no sea necesaria. Así, el modelo recibe solo el contexto que necesita para la decisión actual.
Haz visible el coste de cada tarea
Con miles de agentes y numerosos pasos de razonamiento en cada uno, conocer el gasto total no basta. Tokens, llamadas, herramientas y reintentos deben atribuirse a la unidad de trabajo medible más pequeña. Si no es posible identificar qué tarea está superando su presupuesto, el problema no se puede corregir. Aquí es donde entra en juego el AI FinOps.
Pon límites a la autonomía
No se debe permitir que un agente razone, use herramientas o revise sus resultados de forma indefinida. Todo flujo debe incluir límites de tiempo, tokens, iteraciones e intentos. Una vez superado un umbral, el agente debe detenerse, adoptar una estrategia alternativa o derivar el caso a una persona.
Encuentra el equilibrio adecuado entre coste y calidad
Más razonamiento, más comprobaciones y un modelo más potente no producen automáticamente mejores resultados. Es necesario experimentar con distintas configuraciones y medir el coste de cada tarea completada en cada una de ellas. El objetivo es identificar el punto a partir del cual un mayor consumo ya no aporta una mejora de calidad significativa.
Innovar es convertir la IA en valor, no en coste
En Kirey trabajamos a la vanguardia de la innovación tecnológica, que se apoya cada vez más en agentes de IA. Acompañamos a las empresas en la automatización y evolución de sus procesos, aprovechando las tecnologías más avanzadas y convirtiendo nuestra experiencia en una ventaja competitiva tangible.
Sin embargo, una ventaja no puede considerarse como tal si el retorno de la inversión sigue siendo incierto. Por eso, junto con los muchos retos que plantea la IA agéntica, prestamos especial atención a los costes de inferencia. Nuestro objetivo es evitar que la bajada del precio de los tokens se traduzca, paradójicamente, en un mayor gasto global.
Contacta con nosotros para emprender juntos un camino de innovación que combine el potencial de la IA con control, sostenibilidad económica y resultados medibles.