

Dell’intelligenza artificiale non esiste solo il lato innovativo, ma c’è anche un conto da pagare. E negli ultimi mesi quel conto ha cominciato a preoccupare i CIO di mezzo mondo, già alle prese con l’annosa difficoltà di dimostrare il ROI dei loro investimenti in AI.
Key Points
- Il costo unitario dei token diminuisce, ma la complessità e il consumo dei workflow agentici aumentano più velocemente. Molte aziende sforano sensibilmente i budget previsti.
- Reasoning, chiamate ripetute, contesti estesi, strumenti esterni e autonomia si sommano. Non esiste una sola causa, ma una catena di moltiplicatori spesso difficili da prevedere.
- Gli agenti vanno progettati non solo in funzione dell’obiettivo, ma anche dell’efficienza. È possibile farlo, a condizione di disporre delle competenze e dell’esperienza necessarie.
Il paradosso dell’inferenza: le aziende spendono più di 1 milione all’anno
Ad agosto 2026, Gartner ha battezzato il fenomeno the inference paradox e l’ha descritto in questo modo: “Entro il 2028, i costi di inferenza per ciascun workflow agentico aumenteranno di oltre cinque volte”. Il paradosso sta nel fatto che il costo unitario delle chiamate, misurato in token, continua a diminuire, mentre la spesa complessiva delle aziende cresce.
Ma quanto stanno spendendo le imprese? Secondo IDC, quelle che hanno visibilità sui costi dichiarano una spesa media mensile di 117.558 dollari per inferenza e servizi di orchestrazione, ovvero più di 1,4 milioni di dollari all’anno. E siamo solo all’inizio.
Il dato forse più significativo, però, riguarda l’incapacità di prevedere la spesa: sempre secondo IDC, negli ultimi dodici mesi il 67% delle imprese ha superato di oltre il 10% il budget destinato agli agenti AI; il 24% lo ha oltrepassato in misura ancor più significativa.
E quando il budget salta, le aziende reagiscono nel modo più lineare possibile: rinviano altri progetti IT e il 43,1% riduce il personale per compensare la maggiore spesa.
È decisamente arrivato il momento di cercare una terza via partendo dal presupposto che l’AI non costa tanto perché ogni token è caro, ma perché un’attività apparentemente semplice mette in moto un’intera catena di consumo.
Un workflow agentico può consumare 1.000 volte più token di una chat
Per un CIO, la differenza tra chat e workflow inizia ad essere evidente. In una normale chat il modello riceve una domanda, attinge alle proprie conoscenze e produce una risposta. Un workflow agentico deve ragionare, pianificare, utilizzare strumenti, analizzare i risultati, verificare il proprio lavoro ed eventualmente tornare sui suoi passi.
Chiunque abbia sperimentato le capacità di reasoning dei modelli avrà notato che, con l’aumentare della complessità, crescono anche i tempi di elaborazione e i token consumati, quindi il costo. Ma per capire dove finiscano davvero quei soldi bisogna spingersi più in profondità.
Il modello consuma più volte
Il primo moltiplicatore è interno alla singola chiamata. Quando deve affrontare un problema complesso, il modello non produce immediatamente la risposta, ma impiega capacità di reasoning per analizzare le informazioni, valutare alternative e costruire il risultato. Questa elaborazione richiede token aggiuntivi, anche se dal punto di vista dell’utente tutto sembra avvenire in seguito a un unico prompt. Il modo più semplice per accorgersene sono i tempi, del tutto incompatibili con quelli di una normale chat.
Il secondo moltiplicatore dipende invece dalla struttura del workflow. Per fare un esempio, consideriamo la gestione di una fattura in ingresso. Il modello estrae dal documento fornitore, importo e numero d’ordine; sulla base di questi dati, il workflow interroga l’ERP, consulta l’anagrafica del fornitore e verifica che beni e importi corrispondano all’ordine. Se emerge una discrepanza, il sistema torna al modello con informazioni che prima non possedeva e gli chiede di interpretarla, decidere quali altri controlli eseguire o preparare una richiesta di chiarimento. La risposta ottenuta può innescare nuove verifiche e, quindi, nuove chiamate. È questa alternanza tra reasoning, accesso ai sistemi aziendali e risultati progressivi a trasformare una singola richiesta dell’utente in una sequenza di inferenze.
Come osserva McKinsey, “la parte più costosa non è la generazione della prima risposta, ma il processo successivo di controllo, correzione e nuova verifica”. In altre parole, produrre una risposta è relativamente economico; renderla affidabile molto meno.
L’autonomia non è sempre una bella cosa
I CIO hanno bisogno di costi prevedibili. I modelli AI e i workflow agentici, se non adeguatamente governati, procedono nella direzione opposta. Un agente non segue necessariamente lo stesso percorso di un agente analogo: può formulare piani differenti, scegliere strumenti diversi, ripetere una ricerca, correggere una decisione o rimanere intrappolato in un ciclo di tentativi.
La conseguenza è che due esecuzioni dello stesso compito possono presentare costi radicalmente diversi. Uno studio del 2026 condotto su otto modelli di frontiera ha rilevato variazioni fino a 30 volte nel consumo di token per la medesima attività. Gli stessi modelli, inoltre, si dimostrano poco capaci di prevedere preventivamente il proprio consumo e tendono a sottostimarlo.
C’è poi un secondo tema: utilizzare più token non garantisce più accuratezza. Le prestazioni raggiungono spesso il punto migliore a un livello intermedio di consumo, per poi stabilizzarsi nonostante l’ulteriore spesa. Nel mondo agentico, quindi, aggiungere passaggi, controlli e ragionamenti non significa necessariamente ottenere un risultato migliore. La complessità può diventare consumo senza valore.
A costare non è solo l’inferenza
Un workflow agentico non usa solo il modello AI. Può effettuare ricerche, interrogare database, eseguire codice, generare immagini o accedere a piattaforme SaaS. A ogni chiamata si aggiungono quindi altri consumi: API, capacità di calcolo, licenze, storage e trasferimento dei dati. Il costo del workflow è la somma di tutti questi piccoli contatori, non soltanto dei token.
Velocità e disponibilità si pagano anche quando non vengono usate
Gli agenti AI stanno entrando nei processi critici, dove non basta che il risultato sia di qualità: deve arrivare rapidamente e il servizio deve rimanere sempre disponibile. Garantire tempi di risposta costanti anche nei momenti di picco richiede capacità di calcolo riservata, infrastrutture ridondanti e margini sufficienti per assorbire aumenti improvvisi della domanda. L’azienda continua a pagare queste risorse anche quando il traffico diminuisce e queste rimangono parzialmente inutilizzate.
È l’architettura a definire il costo degli AI Agents
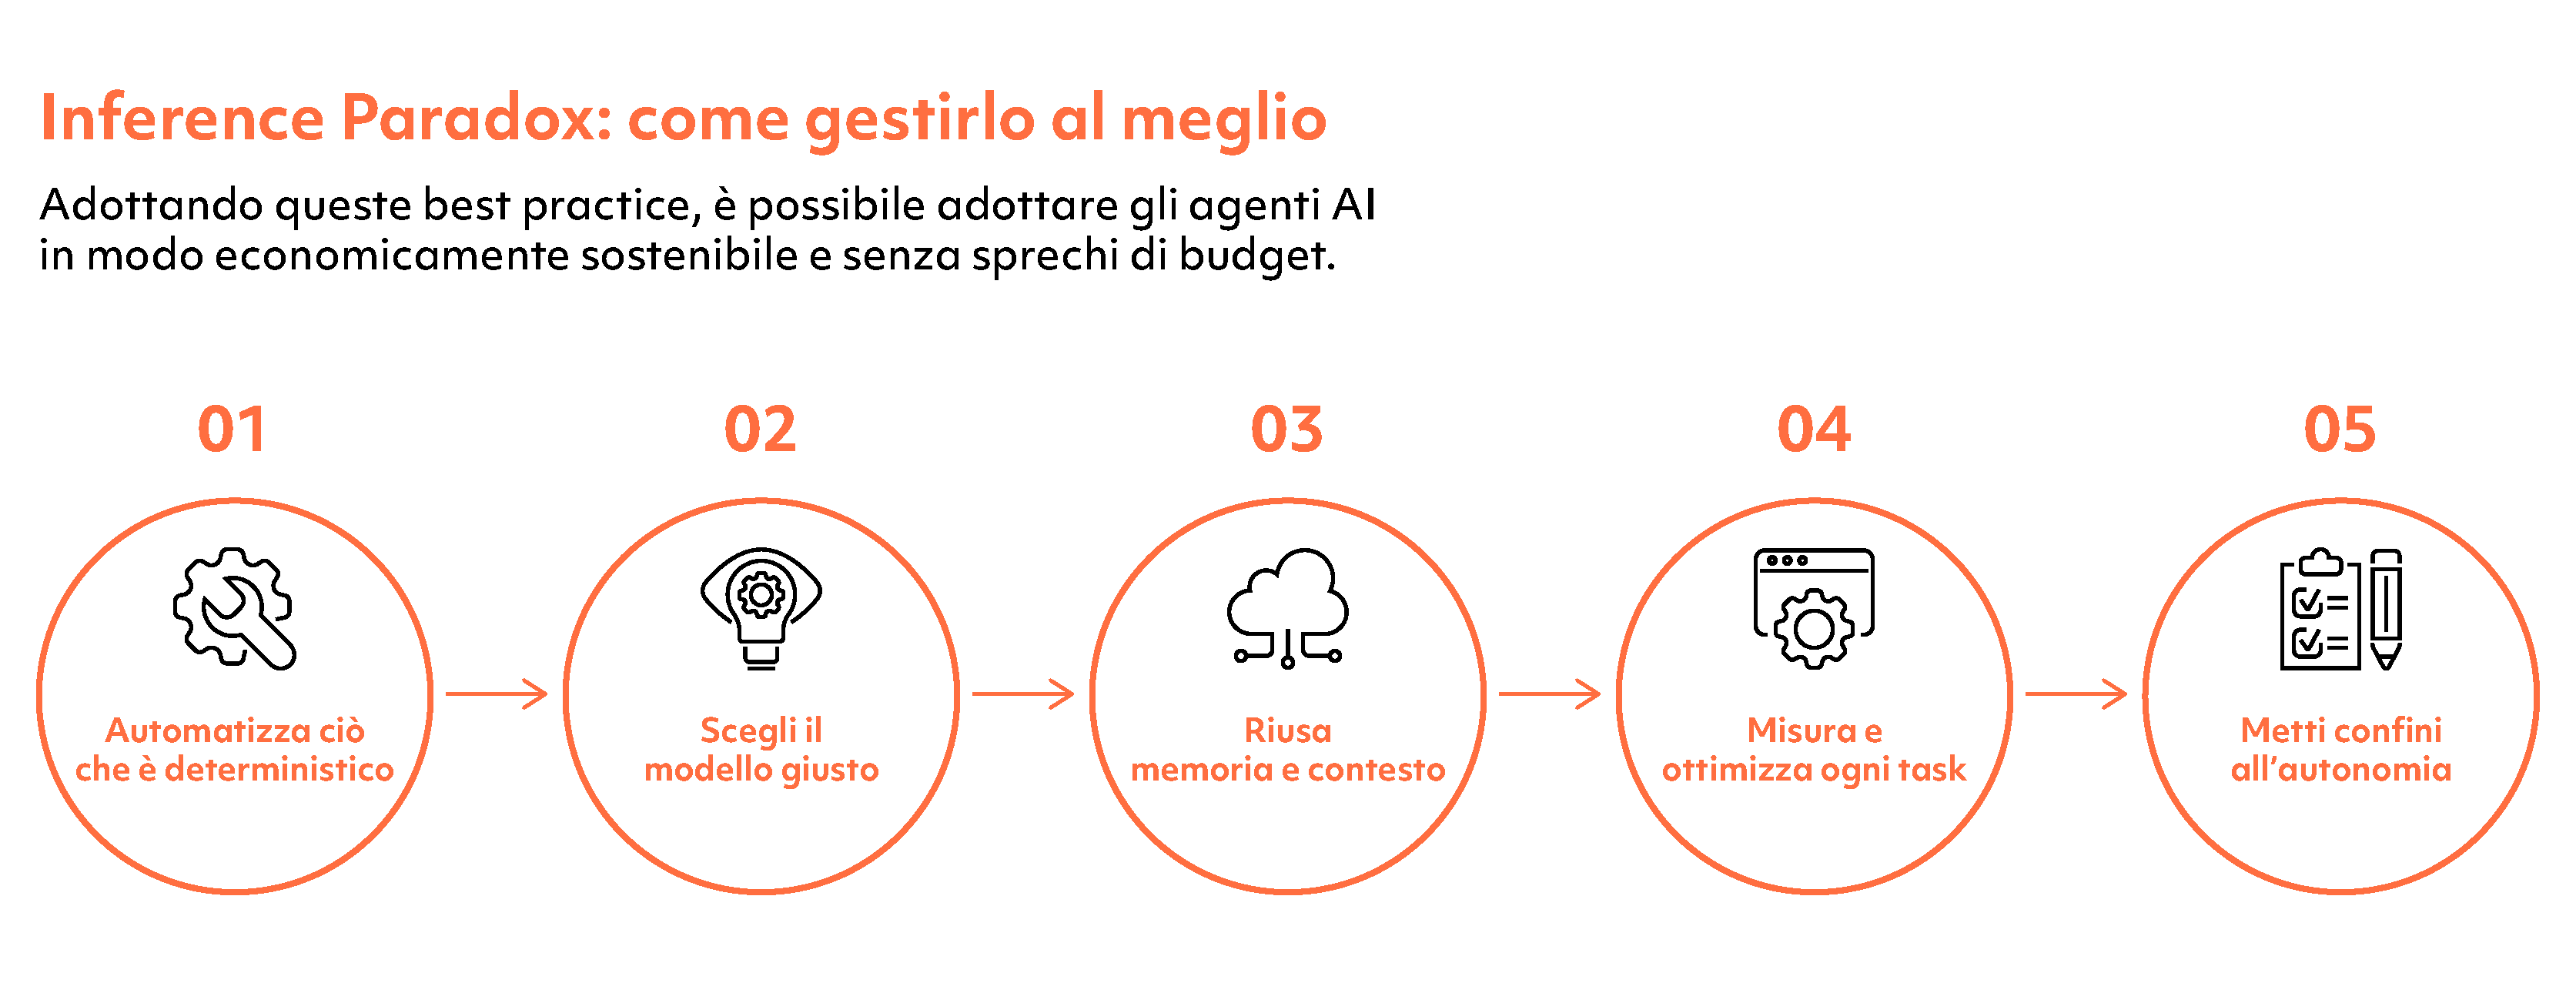
Non esiste una tecnica validata per risolvere il paradosso dell’inferenza. La regola fondamentale è progettare l’agente affinché utilizzi l’AI soltanto quando serve, nella misura necessaria e all’interno di confini precisi. L’efficienza non può essere aggiunta alla fine: deve entrare nell’architettura del workflow fin dall’inizio. In caso contrario, la sorpresa (quasi mai piacevole) è dietro l’angolo.
Non usare l’AI dove basta un database
Calcoli, filtri, confronti e regole deterministiche non richiedono un modello linguistico. Se un’operazione può essere eseguita con una query SQL o poche righe di codice, affidarla all’AI significa renderla più costosa, lenta, meno prevedibile e meno affidabile. Il modello deve intervenire dove occorrono interpretazione, ragionamento o gestione dell’ambiguità.
Assegna a ogni task il modello giusto
Pochi passaggi richiedono il modello più potente e costoso. Estrazione, classificazione e sintesi possono essere affidate a modelli leggeri; reasoning complesso e decisioni ad alto rischio possono giustificare quelli più avanzati. Servono linee guida chiare e un sistema di routing che scelga il modello in base a complessità, valore e rischio del singolo task.
Non pagare più volte lo stesso lavoro
Un agente efficiente deve procedere in modo incrementale, conservando i risultati intermedi invece di ricostruirli a ogni passaggio. Sembra banale, ma senza regole ben definite, il modello ripete nuovamente tutto il ciclo. Le informazioni stabili possono essere memorizzate o messe in cache; quelle temporanee, sintetizzate o eliminate quando non servono più. In questo modo il modello riceve soltanto il contesto necessario alla decisione corrente.
Rendi visibile il costo di ogni task
Con migliaia di agenti e numerosi passaggi cognitivi per ciascuno, conoscere la spesa complessiva non basta. Occorre attribuire token, chiamate, strumenti e retry alla più piccola unità di lavoro misurabile. Se non si riesce a identificare quale task sta superando il budget, non è possibile correggere il problema: qui entra in gioco l’AI FinOps.
Metti confini all’autonomia
Un agente non dovrebbe poter continuare indefinitamente a ragionare, utilizzare strumenti o correggere i propri risultati. Ogni workflow deve prevedere limiti di tempo, token, iterazioni e tentativi. Superata una soglia, l’agente deve interrompersi, adottare una strategia alternativa oppure trasferire il caso a una persona.
Trova il bilanciamento giusto tra costo e qualità
Più reasoning, più verifiche e un modello più potente non producono automaticamente un risultato migliore. Occorre sperimentare configurazioni diverse e misurare per ciascuna il costo di un task completato correttamente. L’obiettivo è individuare il punto oltre il quale l’aumento dei consumi non genera più un miglioramento apprezzabile della qualità.
Innovare significa trasformare l’AI in un valore, non in un costo
In Kirey operiamo alla frontiera dell’innovazione tecnologica, che oggi passa sempre più spesso dagli agenti AI. Affianchiamo le aziende nell’automazione e nell’evoluzione dei processi, facendo leva sulle tecnologie più avanzate e trasformando le nostre conoscenze in un vantaggio competitivo concreto.
Un vantaggio, però, non può dirsi tale se il ritorno sull’investimento rimane incerto. Per questo, insieme alle numerose sfide poste dall’AI agentica, prestiamo particolare attenzione ai costi di inferenza. L’obiettivo è evitare che la riduzione del prezzo dei token si traduca, paradossalmente, in un aumento della spesa complessiva.
Contattaci per avviare insieme un percorso di innovazione capace di coniugare le potenzialità dell’AI con controllo, sostenibilità economica e risultati misurabili.